La Semana Ahora | Economía y finanzas | 23 de octubre de 2026 | Corte: 15:11, Monterrey
Elegir inteligencia artificial ya no consiste en escoger una marca y asumir que su modelo más caro resolverá cualquier trabajo. Las opciones disponibles combinan capacidades, costos y tiempos distintos.
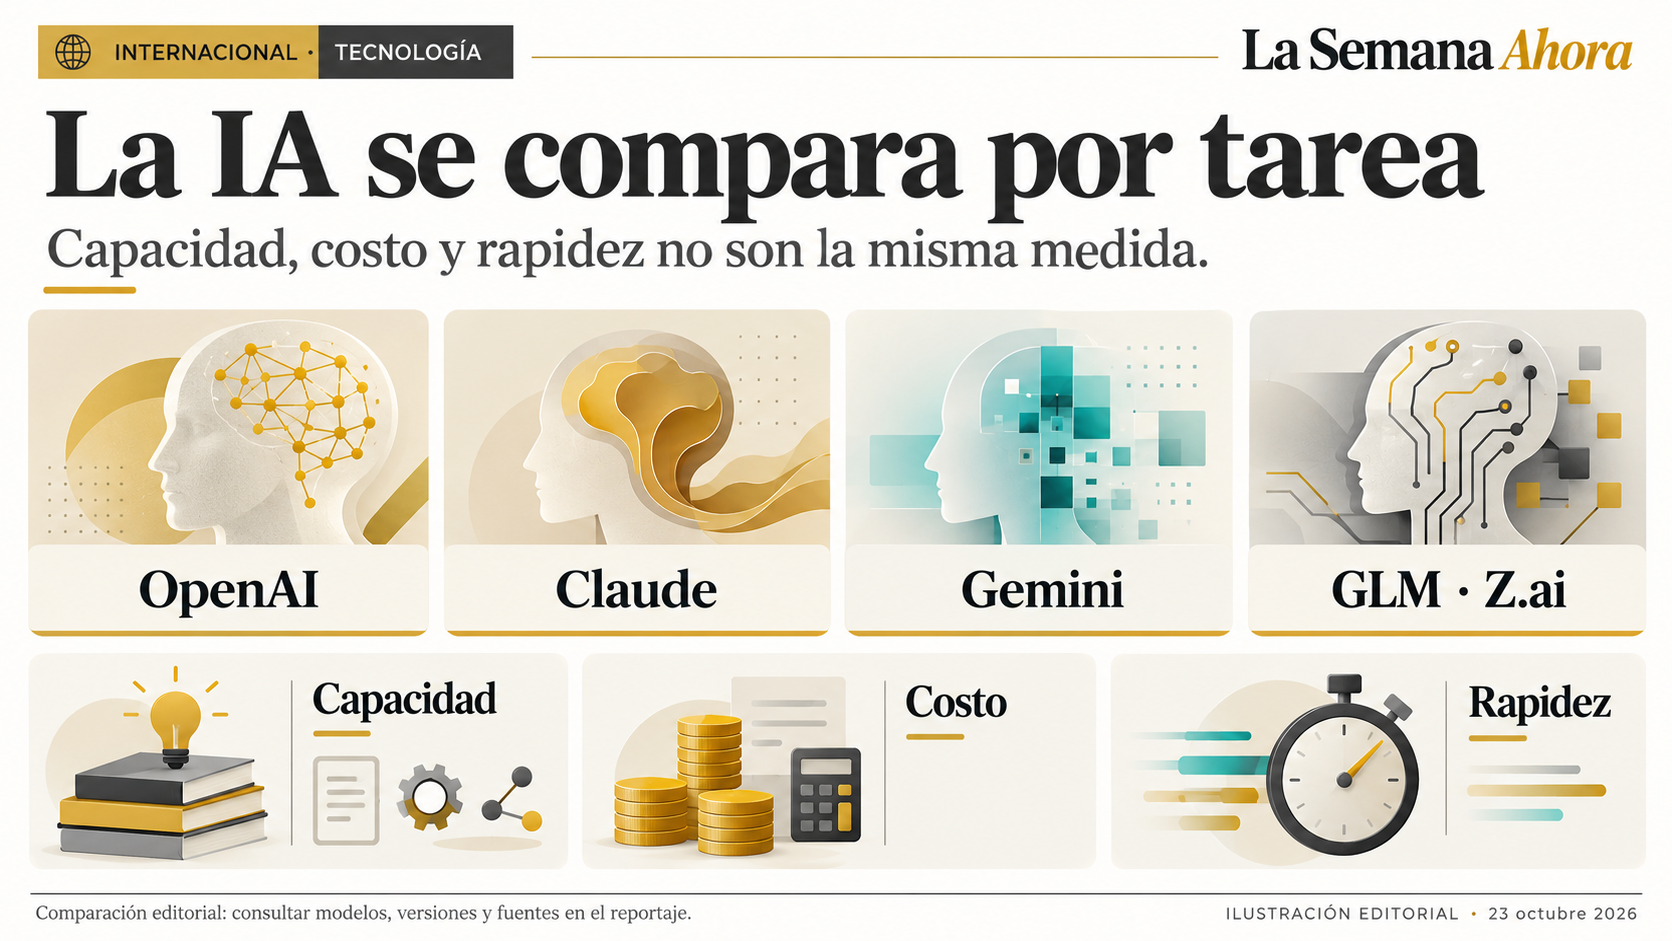
Imagen de encabezado: Capacidad, costo y rapidez orientan una evaluación por tarea; el dibujo no representa un ranking. Elaboración editorial. Ilustración editorial original.
Para una redacción, la pregunta útil es qué sistema ayuda a investigar, escribir o programar con evidencia suficiente y revisión humana.
Esta comparación reúne versiones de OpenAI, Anthropic, Google y Z.ai consultadas el 23 de octubre. No se ejecutaron pruebas propias ni llamadas de pago.
Las tablas dinámicas muestran el estado observado ese día, sin una hora individual que permita reconstruir exactamente cada fila al corte editorial.
Los modelos destacados incluyen GPT-6 Astra, GPT-6.1 Sol y GPT-6 Luna; Claude Fable 5.1, Opus 5.5, Sonnet 5.5 y Haiku 5.5; Gemini 4 Argon y 3.8 Flash; y GLM 5.3 y 5.3 Flash. Las versiones y fechas completas quedan en el anexo comparativo. 1234
La selección cambia según el trabajo y la interfaz. Una aplicación puede añadir búsqueda, archivos y herramientas a un modelo que, por sí solo, no produce todas esas modalidades.
El nombre del producto no basta para identificar qué entrada recibe, qué salida entrega o qué recursos consume.
Las versiones recientes tienen papeles diferentes
OpenAI lanzó Astra el 3 de septiembre, Luna el 22 y Sol 6.1 el 29. Sus fichas describen texto e imágenes de entrada y texto de salida, con contexto de 1.05 millones de tokens. 1567 Eso no equivale a generación nativa de audio o video.
Anthropic sitúa Fable 5.1 para razonamiento exigente y trabajo prolongado; Opus 5.5 es su opción recomendada de inicio para mayor capacidad. Sonnet y Haiku ofrecen otros balances de costo. 2 Es posicionamiento del fabricante, que necesita contrastarse con resultados del trabajo específico.
Las fichas de Google describen Argon y Flash con entrada de texto, imágenes, audio, video y documentos, y salida textual. Argon alcanzó disponibilidad general el 13 de octubre; Flash, el 2 de septiembre. 389
Esa amplitud puede ser relevante para fuentes heterogéneas, sin garantizar interpretación correcta de cada archivo.
GLM 5.3 admite texto, mientras 5.3 Flash incorpora entradas multimodales. Sus lanzamientos oficiales están fechados en agosto. 41011 Trasladar capacidad visual del segundo al primero produciría una comparación falsa, aunque compartan familia y una ventana de contexto amplia.
El contexto expresa capacidad de una solicitud, no memoria permanente ni comprensión perfecta. El límite unificado de Argon cuenta entrada y salida. 8 Un millón de tokens recibidos y otros cien mil generados no caben automáticamente porque el catálogo utilice la expresión contexto de un millón.
Para principiantes, una aplicación con archivos y búsqueda puede ser más sencilla que una integración API. Para un equipo técnico, la API permite definir herramientas y evaluación propia, pero añade responsabilidades de operación.
Esa diferencia práctica no convierte a un canal en intrínsecamente más inteligente que el otro.
Las pruebas de capacidad no son un cociente intelectual
Artificial Analysis combina diez evaluaciones en su índice, incluyendo tareas de razonamiento, conocimiento, código y trabajo con documentos. 12 Es una medida construida bajo una metodología. No representa una escala universal de inteligencia ni una prueba específica de investigación periodística en español.
En la tabla consultada, Opus 5.5 con esfuerzo máximo y fallback marca 58; Astra máximo y Argon alto, 53; GLM 5.3 máximo, 45. 13 Las etiquetas son parte del resultado. Quitar configuración y presentarlo como una propiedad absoluta del nombre comercial borraría condiciones relevantes.
Tampoco son intercambiables todos los niveles llamados alto o máximo. Cada proveedor define su funcionamiento. Una comparación de configuraciones existentes puede ser útil, pero no prueba igualdad de esfuerzo computacional ni permite atribuir toda diferencia a una sola característica del modelo.
Arena ofrece otra perspectiva: preferencias humanas entre respuestas. En la consulta aparecen Argon alto con 1517, todavía preliminar, y Opus alto con 1509, ambos con intervalos de siete puntos. 14 Son puntuaciones de preferencia, no porcentajes de acierto ni niveles de conocimiento humano.
Los intervalos y la composición de preguntas importan. Una diferencia pequeña no justifica proclamar superioridad estable para cualquier tarea. Preferir una respuesta por claridad o estilo tampoco garantiza que sus nombres, fechas y afirmaciones estén respaldados por fuentes recuperables.
El propio marco de Arena distingue evaluación de factualidad de la preferencia general. 15 Para una redacción, esa separación es crucial: una respuesta convincente puede requerir correcciones. El control editorial necesita comprobar evidencia, no delegar publicación en un lugar alto del ranking.
Un ejemplo oficial de OpenAI con socios utiliza 108 preguntas sobre encuestas laborales estadounidenses y un juez automático. Astra y Sol 6.1 obtienen 0.94, con una corrida por modelo. El documento considera insuficiente la diferencia para ordenarlos de forma fiable. 16
Ese ejemplo aporta metodología concreta y una advertencia sobre transferencia. Resolver consultas con herramientas en un entorno definido no equivale a producir mejor reportaje largo. La calidad periodística incluye fidelidad de citas, contraste y capacidad de reconocer incertidumbre, además de redacción fluida.
Esperar el primer fragmento no equivale a terminar
Artificial Analysis publica medianas de rendimiento con un esquema predeterminado de diez mil tokens de entrada, al menos mil quinientos de salida y observaciones durante 72 horas. 17 La medición incluye condiciones de servidor y red; no describe directamente la experiencia de cada lector desde México.
La primera señal recibida puede ser razonamiento cuando una API lo expone. El primer token de respuesta final llega después. Los tokens por segundo describen generación tras la demora inicial, no tiempo completo de resolución.
Mezclar esos valores produciría una comparación engañosa entre sistemas que exponen trabajo de formas distintas.
Por eso no corresponde dividir tres segundos de una columna entre varios cientos de otra y anunciar una ventaja equivalente para obtener respuestas terminadas. Primero hay que conocer qué fragmento mide cada proveedor y cuánto trabajo falta después de esa señal.
La velocidad también cambia con esfuerzo y herramientas. Una investigación con búsqueda puede tardar por recuperación de fuentes, análisis y revisiones. Reducir demora sin conservar exactitud no mejora necesariamente el trabajo. La medida pertinente incluye tiempo de verificación humana hasta disponer de un resultado publicable.
OpenAI ofrece niveles de servicio rápidos y Ultrafast para modelos compatibles, con tarifas superiores. 18 Elegirlos modifica condiciones de procesamiento, no demuestra una ganancia universal de calidad. El presupuesto de servicio y el esfuerzo de razonamiento son controles diferentes.
La factura depende de tokens, contexto y cargos adicionales
El ejemplo común del anexo utiliza veinte solicitudes de cincuenta mil tokens de entrada y cinco mil de salida facturable cada una. Acumula un millón y cien mil, respectivamente, con tarifa estándar, sin caché, lotes, herramientas ni impuestos. Es cálculo editorial, no ejecución medida.
Con ese volumen, Astra y Claude Fable cuestan quince dólares; Opus, seis; Sol 6.1, Sonnet y Argon, tres. Luna y Haiku cuestan quince centavos. 192021222325 Son costos normalizados por cantidad, no garantías de igual calidad o igual número de intentos.
Gemini Flash suma 1.125 dólares; GLM 5.3, 1.84; y GLM Flash, veinte centavos. 2324 El precio de Argon es promocional hasta el 30 de noviembre y el de Gemini Flash hasta el 31 de diciembre. Las condiciones futuras no deben presentarse como tarifas ya vigentes.
El escenario mantiene solicitudes cortas para evitar umbrales especiales. Haiku cambia sus tarifas cuando la entrada supera cien mil tokens; los modelos GPT destacados aplican precios distintos sobre 272 mil. 56725 El volumen acumulado no equivale a una solicitud única de ese tamaño.
La salida facturable puede incluir razonamiento no visible. Si cien mil tokens ya lo incluyen, añadirlo otra vez duplicaría costo. Si se requieren cien mil visibles más razonamiento adicional, debe incorporarse ese trabajo con la tarifa correspondiente. 26
Más espera y más texto no son sinónimos de mejor evidencia.
La caché también tiene condiciones: lectura, escritura o almacenamiento pueden cobrarse de manera distinta. Una tarifa reducida de lectura no representa automáticamente el precio de preparar una solicitud nueva. El anexo conserva esas columnas para evitar que un descuento aislado se interprete como factura completa.
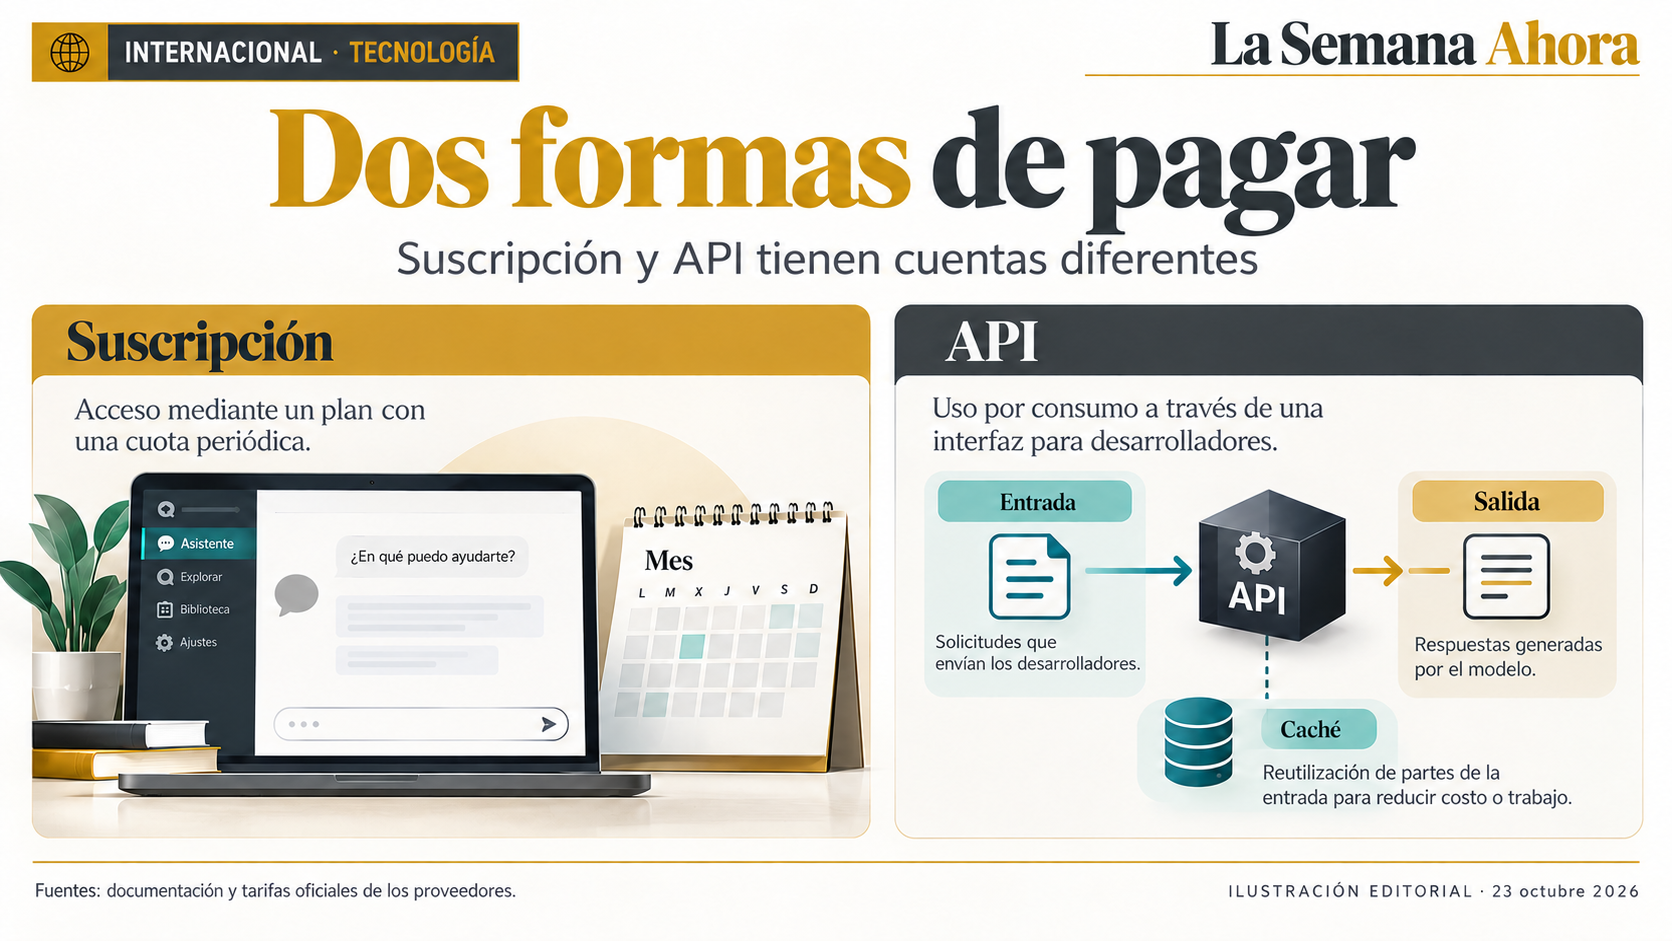
Suscripción y API tienen condiciones distintas. La caché reutiliza entrada, no respuestas. Esquema conceptual basado en documentación comercial de los proveedores. Ilustración e infografía original.
Las suscripciones compran acceso a un producto
Los planes de usuario tienen límites y herramientas diferentes del consumo API. ChatGPT Learn publica Plus por veinte dólares y Pro desde cien; Claude ofrece Pro por veinte al mes; Gemini Pro aparece en la página estadounidense por 19.99. 272829
No son precios mexicanos con impuestos comprobados.
GLM Coding Plan anuncia acceso desde dieciocho dólares mensuales y límites propios. 30 No corresponde tratarlo como API estándar ilimitada. El precio de un plan no permite calcular cuántos reportajes o ejecuciones incluye sin considerar reglas y consumo del producto.
Comparar una factura hipotética de tres dólares con una mensualidad de veinte no identifica al ganador económico. Compran cargas y servicios diferentes.
Para evaluar presupuesto conviene separar frecuencia de uso, herramientas necesarias y costo de integrar y revisar resultados, sin sumar créditos como si fueran tokens equivalentes.
Investigar, redactar y programar requieren criterios de evaluación distintos. Ilustración conceptual; no representa pruebas realizadas. Ilustración e infografía original.
Una redacción puede elegir por tarea y experiencia
Para investigación compleja, Astra y Fable son candidatos por el posicionamiento de sus fabricantes, sin una superioridad periodística demostrada aquí. 52 Para código, un equipo técnico puede probar Opus o Sol con casos propios, revisión de cambios y pruebas que acrediten resultados concretos plenamente verificables.
Para audio, video y documentos mezclados, Argon o Flash ofrecen entradas nativas amplias. Para clasificación y extracción de volumen, Luna, Haiku o GLM Flash pueden merecer una muestra de prueba. La decisión depende de errores tolerables, tiempos y revisión, no solo del precio anunciado.
Un equipo técnico puede incorporar GLM y otros modelos mediante API, establecer salidas estructuradas y verificar casos repetibles. Una persona sin esa infraestructura puede comenzar con una aplicación suficiente.
La elección más útil será la que cumpla requisitos documentados y pueda revisarse, no la que prometa inteligencia universal.
La cronología evita confundir anuncio y acceso general. Anthropic fecha Fable en septiembre y Haiku en octubre; Google distingue el acceso restringido previo de Argon de su disponibilidad general. 28 La versión concreta permite reconocer qué información corresponde al producto comparado.
Las preferencias de esfuerzo añaden una decisión práctica. Astra y Sol 6.1 no admiten esfuerzo nulo, mientras Luna sí lo permite. 567 Eso no determina el costo: la salida facturable del escenario puede incorporar razonamiento generado dentro de su presupuesto.
Si se utiliza una aplicación, las herramientas disponibles pueden cambiar la experiencia con el mismo modelo subyacente. Buscar fuentes y adjuntar documentos son pasos del trabajo, no demostraciones de que la respuesta final sea correcta. Una evaluación necesita conservar también esas condiciones.
El anexo separa fecha de lanzamiento, modalidades y tarifas. Esa estructura ayuda a evitar que una novedad comercial se confunda con un resultado evaluado. Un modelo más nuevo puede merecer pruebas sin desplazar automáticamente la opción que ya cumple las necesidades de un equipo.
Para tareas repetidas, una muestra de casos permite definir errores importantes. En extracción de cifras, mezclar anual y mensual tiene consecuencias distintas de una preferencia de estilo. La rúbrica debería reconocer esa diferencia y conservar un estándar estable al cambiar de proveedor.
En investigación, la referencia recuperable importa tanto como la formulación. Una cita que no permite llegar a su fuente necesita revisión, aunque aparezca en una respuesta extensa. Las herramientas pueden facilitar recuperación, pero no sustituyen comprobar autoría, fecha y alcance de lo afirmado.
En código, conviene separar propuestas y resultados comprobados. Una solución puede parecer razonable y necesitar pruebas antes de integrarse. La capacidad de producir cambios con rapidez aporta valor cuando el equipo puede revisarlos y verificar que resuelven el problema planteado.
La relación con el nivel técnico tampoco es permanente. Una aplicación permite comenzar con menos configuración; una API ofrece controles adicionales cuando existe capacidad para administrarlos. Pasar de una a otra debe responder a una necesidad, no a la idea de que complejidad garantiza respuestas.
El costo de revisión puede cambiar la elección económica. Un modelo barato que obliga a corregir mucho puede resultar inconveniente para un trabajo exigente. Esa posibilidad debe medirse con casos: ni la tarifa más alta demuestra superioridad ni la más baja asegura ahorro final.
La competencia ofrece alternativas premium y económicas con diferencias reales, pero ningún índice autoriza publicar automáticamente. Para el trabajo periodístico, la comparación termina en evidencia contrastable, citas fieles y responsabilidad editorial.
Capacidad, rapidez y costo importan cuando ayudan a conseguir ese resultado, no como sustitutos de él.
Fuentes y fechas
[1] OpenAI, historial de lanzamientos.
[2] Anthropic, catálogo de modelos.
[3] Google, historial de lanzamientos.
[4] Z.ai, notas de lanzamiento.
[5] OpenAI, GPT-6 Astra.
[6] OpenAI, GPT-6.1 Sol.
[7] OpenAI, GPT-6 Luna.
[10] Z.ai, GLM 5.3.
[11] Z.ai, GLM 5.3 Flash.
[12] Artificial Analysis, metodología del índice.
[13] Artificial Analysis, tabla dinámica de modelos.
[14] Arena, tabla dinámica de preferencias.
[15] Arena, evaluación de factualidad.
[16] OpenAI, evaluación con herramientas y 108 preguntas BLS.
[17] Artificial Analysis, metodología de rendimiento.
[18] OpenAI, Ultrafast.
[19] OpenAI, tarifas API.
[20] Anthropic, Fable 5.1.
[21] Anthropic, Opus 5.5.
[22] Anthropic, Sonnet 5.5.
[23] Google, tarifas API.
[24] Z.ai, tarifas API.
[25] Anthropic, Haiku 5.5.
[26] OpenAI, razonamiento y facturación.
[27] ChatGPT Learn, planes Work y Codex.
[28] Claude, planes de usuario.
[29] Gemini, suscripciones de Estados Unidos.
[30] Z.ai, Coding Plan.
Las páginas dinámicas y comerciales se consultaron el 23 de octubre de 2026; no tienen una hora individual archivada. Sus filas no se presentan como una reconstrucción exacta del corte de las 15:11. No se hicieron pruebas propias. Véase COMPARATIVA_IA.md para supuestos y resultados completos.
Anexo: comparación de modelos de IA
Anexo del reportaje de AHORA DIARIO. Consulta documental del 23 de octubre, sin pruebas propias ni consumo de API. Las tablas dinámicas no tienen hora individual archivada: no reconstruyen exactamente el corte editorial de las 15:11, Monterrey. Precios en USD, sin impuestos ni verificación de oferta mexicana. Este anexo queda fuera de las 2,000 palabras del cuerpo.
Versiones y capacidades documentadas
| Modelo | Identificador API | Disponibilidad | Entrada → salida | Contexto / máximo salida (tokens) | Fuente |
|---|---|---|---|---|---|
| GPT-6 Astra | gpt-6-astra | 3 sep 2026 | Texto, imagen → texto | 1.05M / 128K | 5 |
| GPT-6.1 Sol | gpt-6.1-sol | 29 sep 2026 | Texto, imagen → texto | 1.05M / 128K | 6 |
| GPT-6 Luna | gpt-6-luna | 22 sep 2026 | Texto, imagen → texto | 1.05M / 128K | 7 |
| Claude Fable 5.1 | claude-fable-5-1 | 1 sep 2026 | Texto, imagen → texto | 1M / 128K | 20 |
| Claude Opus 5.5 | claude-opus-5-5 | 22 sep 2026 | Texto, imagen → texto | 1M / 128K | 21 |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | 28 sep 2026 | Texto, imagen → texto | 1M / 128K | 22 |
| Claude Haiku 5.5 | claude-haiku-5-5 | 7 oct 2026 | Texto, imagen → texto | 1M / 128K | 25 |
| Gemini 4 Argon | gemini-4-argon | 13 oct 2026, general | Texto, imagen, audio, video, PDF → texto | 1,048,576 unificado / 65,536 síncrona | 8 |
| Gemini 3.8 Flash | gemini-3.8-flash | 2 sep 2026 | Texto, imagen, audio, video, PDF → texto | 1,048,576 entrada / 65,536 | 9 |
| GLM 5.3 | glm-5.3 | 18 ago 2026 | Texto → texto | 1M / 128K | 10 |
| GLM 5.3 Flash | glm-5.3-flash | 26 ago 2026 | Texto, imagen, video, archivos → texto | 1M / 128K | 11 |
Argon cuenta entrada y salida dentro del total unificado; long decode admite hasta un millón de salida sujeto a ese total. Contexto máximo no es memoria permanente ni garantía de recuperar cualquier detalle. Las herramientas de una aplicación pueden ampliar el flujo sin cambiar la modalidad nativa del endpoint.
Tarifas API comparables
Escenario editorial: veinte solicitudes de 50,000 tokens de entrada y 5,000 de salida facturable cada una; acumulados 1,000,000 + 100,000. Prompts cortos, sin caché, lotes, herramientas, almacenamiento, impuestos ni cargos adicionales. Costo = entrada + 0.1 × salida por millón. No mide calidad, repeticiones ni costo por reportaje.
| Modelo | Entrada USD/1M | Lectura caché USD/1M | Salida USD/1M | Costo escenario USD | Fuente |
|---|---|---|---|---|---|
| GPT-6 Astra | 10 | 1 | 50 | 15 | 19 |
| GPT-6.1 Sol | 2 | 0.1 | 10 | 3 | 19 |
| GPT-6 Luna | 0.1 | 0.01 | 0.5 | 0.15 | 19 |
| Claude Fable 5.1 | 10 | 0.25 | 50 | 15 | 20 |
| Claude Opus 5.5 | 4 | 0.2 | 20 | 6 | 21 |
| Claude Sonnet 5.5 | 2 | 0.1 | 10 | 3 | 22 |
| Claude Haiku 5.5 | 0.1 | 0.01 | 0.5 | 0.15 | 25 |
| Gemini 4 Argon | 2 | 0.1 | 10 | 3 | 23 |
| Gemini 3.8 Flash | 0.75 | 0.075 | 3.75 | 1.125 | 23 |
| GLM 5.3 | 1.4 | 0.26 | 4.4 | 1.84 | 24 |
| GLM 5.3 Flash | 0.15 | 0.03 | 0.5 | 0.2 | 24 |
Argon: promoción hasta el 30 de noviembre de 2026; después 4 / 0.20 / 20. Gemini Flash: promoción hasta el 31 de diciembre; después 1.50 / 0.15 / 7.50. Google cobra almacenamiento de caché a 0.50 USD/M tokens/hora; no incluido. 23
Haiku con entrada superior a 100K: 0.50 / 0.05 / 2.50, cinco veces la fila base. 25 Los GPT destacados con entrada superior a 272K multiplican entrada/caché por dos y salida por 1.5 para la llamada completa. 19
Caché reutiliza entrada; no significa reutilizar respuestas. Escritura OpenAI de 30 minutos: Astra 12.50, Sol 2.50, Luna 0.125; de doce horas: 25, 5, 0.25 USD/M. Batch/Flex descuentan 50%; Fast cuesta dos veces y Ultrafast seis veces en modelos compatibles. Son alternativas excluidas del ejemplo. 19 18
Anthropic escritura de cinco minutos, Fable/Opus/Sonnet/Haiku: 12.50 / 5 / 2.50 / 0.125; de una hora: 20 / 8 / 4 / 0.20 USD/M. 20 21 22 25
Los tokens de razonamiento pueden integrar salida facturable. Si los 100K ya los incluyen, no se agregan de nuevo; si se exigen 100K visibles adicionales, hay que presupuestarlos aparte. 26 Una cantidad idéntica de tokens no implica textos idénticos entre tokenizadores.
Capacidad y rendimiento medidos por Artificial Analysis
| Configuración | Índice | Tokens/s | Primer fragmento, segundos |
|---|---|---|---|
| Opus 5.5 max + fallback | 58 | 96 | 588.68 |
| Sonnet 5.5 max + fallback | 56 | 132 | 373.43 |
| Fable 5.1 max + fallback | 53 | 68 | 164.48 |
| Astra max | 53 | 56 | 246.99 |
| Argon high | 53 | 82 | 53.92 |
| Sol 6.1 max | 52 | 54 | 236.01 |
| GLM 5.3 max | 45 | 85 | 3 |
| GLM 5.3 Flash | 42 | 69 | 3.38 |
| Gemini 3.8 Flash high | 41 | 141 | 24.31 |
| Luna max | 38 | 136 | 64.91 |
Fuente: 13. Índice v4.3.2, diez evaluaciones; no cociente intelectual. 12 Rendimiento: medianas, últimas 72 horas, entrada 10K, salida mínima 1,500, ocho observaciones diarias, servidor us-central1-a. 17
Primer fragmento puede ser razonamiento expuesto, no respuesta final; tokens/s excluye demora inicial. No dividir estas latencias para afirmar una ventaja equivalente de tiempo hasta terminar. Configuraciones y exposición difieren. Las filas no miden directamente trabajo periodístico en español.
Preferencias humanas de Arena
| Configuración | Puntuación e intervalo | Votos |
|---|---|---|
| Argon high, preliminar | 1517 ±7 | 10,083 |
| Opus high | 1509 ±7 | 10,322 |
| GLM 5.3 max | 1481 ±5 | 25,144 |
| Sol 6.1 max | 1480 ±7 | 8,305 |
| Astra max | 1476 ±6 | 14,076 |
Fuente: 14. Son preferencias, no exactitud ni IQ; intervalos y muestra condicionan la comparación. El valor preliminar requiere cautela. Arena evalúa factualidad por separado. 15
Prueba oficial con herramientas: alcance acotado
OpenAI publica 108 preguntas sobre 56 encuestas laborales BLS, con juez automático GPT-5.6 Sol y entorno Codex 0.159.2. Una corrida de la tabla arroja Astra/Sol 0.94 y Luna 0.88; el documento no considera fiable ordenar los dos primeros. No equivale a prueba periodística propia. La cabecera lleva 23 de septiembre, pero incluye Sol lanzado después: fecha exacta de actualización no acreditada; consulta 23 de octubre. 16
Suscripciones de usuario, distintas de API
| Producto / mercado de página | Plan y precio USD | Fuente |
|---|---|---|
| ChatGPT Learn, Work/Codex | Free 0; Go 8; Plus 20/mes; Pro 100, 200 o 500/mes; Business 20 por usuario/mes anual (mínimo dos), o 25 mensual; Enterprise a consulta | 27 |
| Claude | Free 0; Pro 20/mes o 200/año; Max desde 100/mes, opciones 5× y 20× con límites propios | 28 |
| Gemini, Estados Unidos | Plus 4.99; Pro 19.99; Ultra 99.99 (5×) o 199.99 (20×) mensuales | 29 |
| GLM Coding Plan | Desde 18/mes; límites propios por ventanas, no API estándar ilimitada | 30 |
Los planes no prometen cantidades equivalentes de tokens ni trabajo. No se comprobó precio mexicano con impuestos ni disponibilidad efectiva en una cuenta concreta. La página Learn está orientada a Work/Codex y no representa todas las cuotas de ChatGPT.
Cómo probar opciones en una redacción
| Trabajo | Opciones para evaluar | Criterio de revisión |
|---|---|---|
| Corrección y síntesis con documentos | Sol, Sonnet; Opus si requiere mayor capacidad | Fidelidad, fuentes, omisiones y tiempo humano |
| Investigación compleja | Astra, Fable, Opus, Argon con herramientas adecuadas | Recuperación de evidencia y atribuciones verificables |
| Audio, video y documentos heterogéneos | Argon o Gemini Flash | Transcripción/contexto, no solo fluidez |
| Extracción y clasificación de volumen | Luna, Haiku, GLM Flash | Errores por campo y costo total corregido |
| Código con equipo técnico | Sol, Sonnet, GLM; comparar variantes exigentes | Pruebas y revisión de cambios |
Estas son propuestas editoriales de prueba según capacidades documentadas; no resultados de ensayos propios ni un ranking universal.
Fuentes enlazadas
[1] OpenAI, historial de lanzamientos. Consulta: 23 de octubre de 2026.
[2] Anthropic, catálogo de modelos. Consulta: 23 de octubre de 2026.
[3] Google, historial de lanzamientos. Consulta: 23 de octubre de 2026.
[4] Z.ai, notas de lanzamiento. Consulta: 23 de octubre de 2026.
[5] OpenAI, GPT-6 Astra. Consulta: 23 de octubre de 2026.
[6] OpenAI, GPT-6.1 Sol. Consulta: 23 de octubre de 2026.
[7] OpenAI, GPT-6 Luna. Consulta: 23 de octubre de 2026.
[8] Google, Gemini 4 Argon. Consulta: 23 de octubre de 2026.
[9] Google, Gemini 3.8 Flash. Consulta: 23 de octubre de 2026.
[10] Z.ai, GLM 5.3. Consulta: 23 de octubre de 2026.
[11] Z.ai, GLM 5.3 Flash. Consulta: 23 de octubre de 2026.
[12] Artificial Analysis, metodología del índice. Consulta: 23 de octubre de 2026.
[13] Artificial Analysis, tabla dinámica de modelos. Consulta: 23 de octubre de 2026.
[14] Arena, tabla dinámica de preferencias. Consulta: 23 de octubre de 2026.
[15] Arena, evaluación de factualidad. Consulta: 23 de octubre de 2026.
[16] OpenAI, evaluación con herramientas y 108 preguntas BLS. Consulta: 23 de octubre de 2026.
[17] Artificial Analysis, metodología de rendimiento. Consulta: 23 de octubre de 2026.
[18] OpenAI, Ultrafast. Consulta: 23 de octubre de 2026.
[19] OpenAI, tarifas API. Consulta: 23 de octubre de 2026.
[20] Anthropic, Fable 5.1. Consulta: 23 de octubre de 2026.
[21] Anthropic, Opus 5.5. Consulta: 23 de octubre de 2026.
[22] Anthropic, Sonnet 5.5. Consulta: 23 de octubre de 2026.
[23] Google, tarifas API. Consulta: 23 de octubre de 2026.
[24] Z.ai, tarifas API. Consulta: 23 de octubre de 2026.
[25] Anthropic, Haiku 5.5. Consulta: 23 de octubre de 2026.
[26] OpenAI, razonamiento y facturación. Consulta: 23 de octubre de 2026.
[27] ChatGPT Learn, planes Work y Codex. Consulta: 23 de octubre de 2026.
[28] Claude, planes de usuario. Consulta: 23 de octubre de 2026.
[29] Gemini, suscripciones de Estados Unidos. Consulta: 23 de octubre de 2026.
[30] Z.ai, Coding Plan. Consulta: 23 de octubre de 2026.