Una orden corriente puede terminar en un movimiento peligroso si el sistema que prepara las acciones de un robot fue comprometido. Una demostración de Binghamton University explora riesgos y una defensa experimental: revisar el plan antes de que sus instrucciones se conviertan en conducta física.
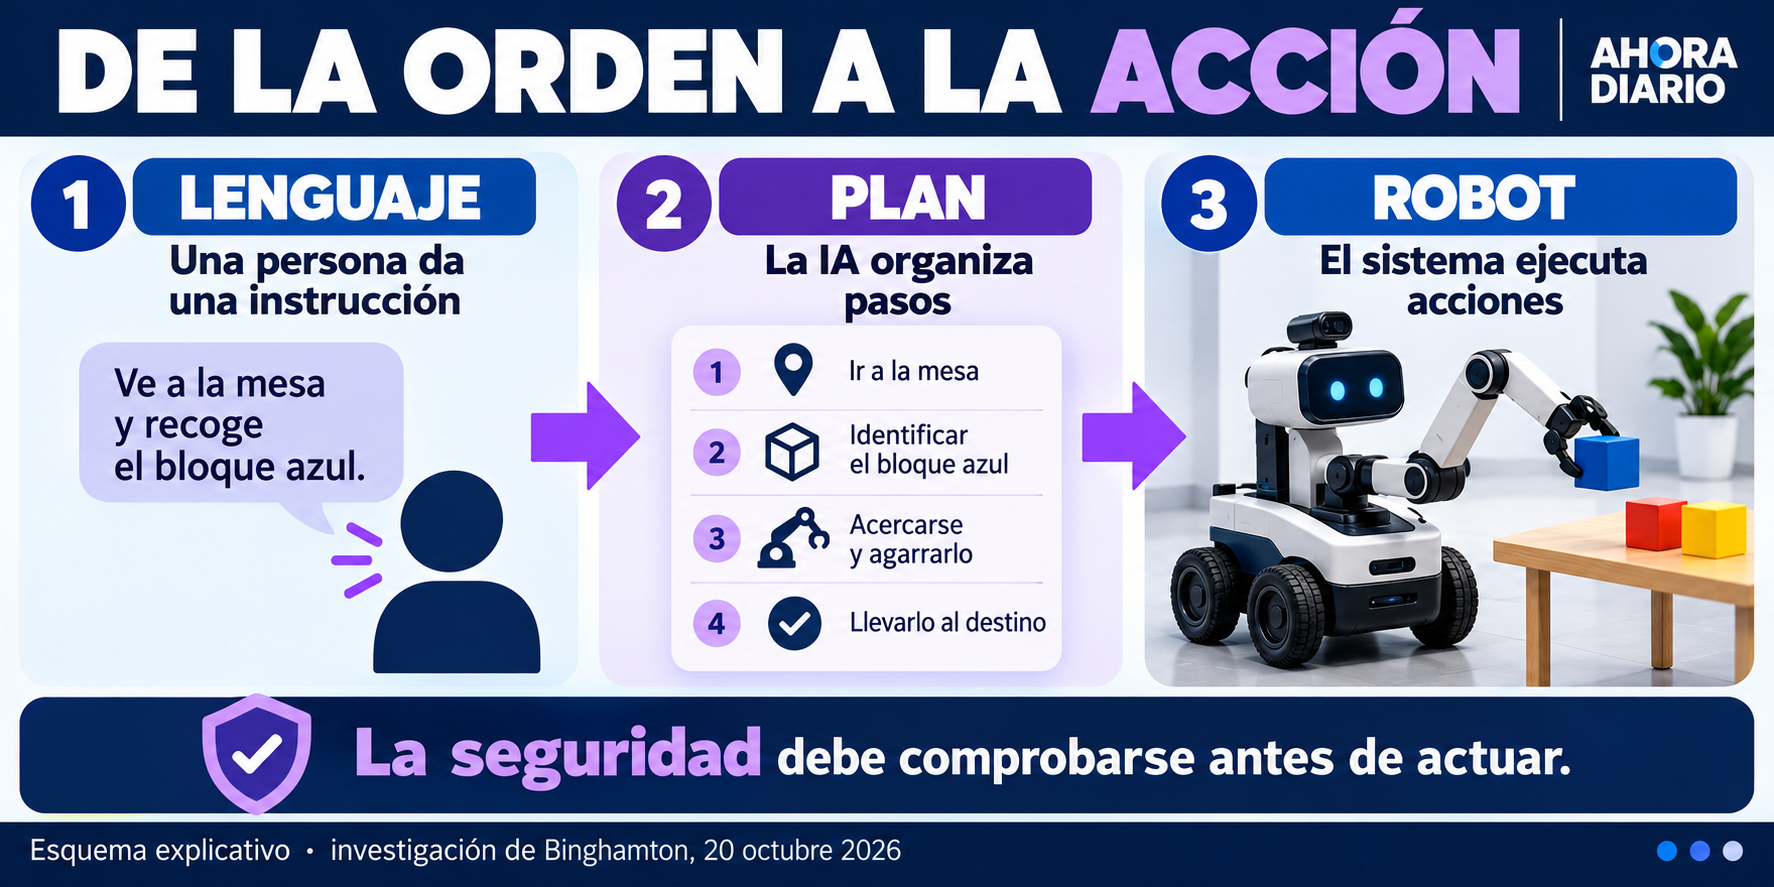
Del lenguaje al movimiento: ejemplo conceptual con un bloque azul, distinto de la demostración experimental. Ilustración e infografía original.
La universidad difundió este 20 de octubre dos investigaciones, MuTRAP y PROTEA. En una prueba controlada, el equipo utilizó una plataforma móvil, fruta plástica y una mano modelo. No documentó lesiones humanas ni un ataque cotidiano contra usuarios de robots comerciales. 1
El interés del trabajo está en una frontera concreta de la automatización: los modelos de lenguaje pueden ayudar a organizar tareas, pero sus respuestas necesitan controles cuando afectan objetos y personas. Un texto equivocado y una acción física equivocada tienen consecuencias diferentes.
Los estudios tampoco acaban de aparecer. MuTRAP tuvo su primera versión en abril de 2025 y una revisión en junio de 2026; PROTEA fue presentado en enero de este año. La noticia reciente es su divulgación universitaria, no la primera publicación de ambos documentos. 23
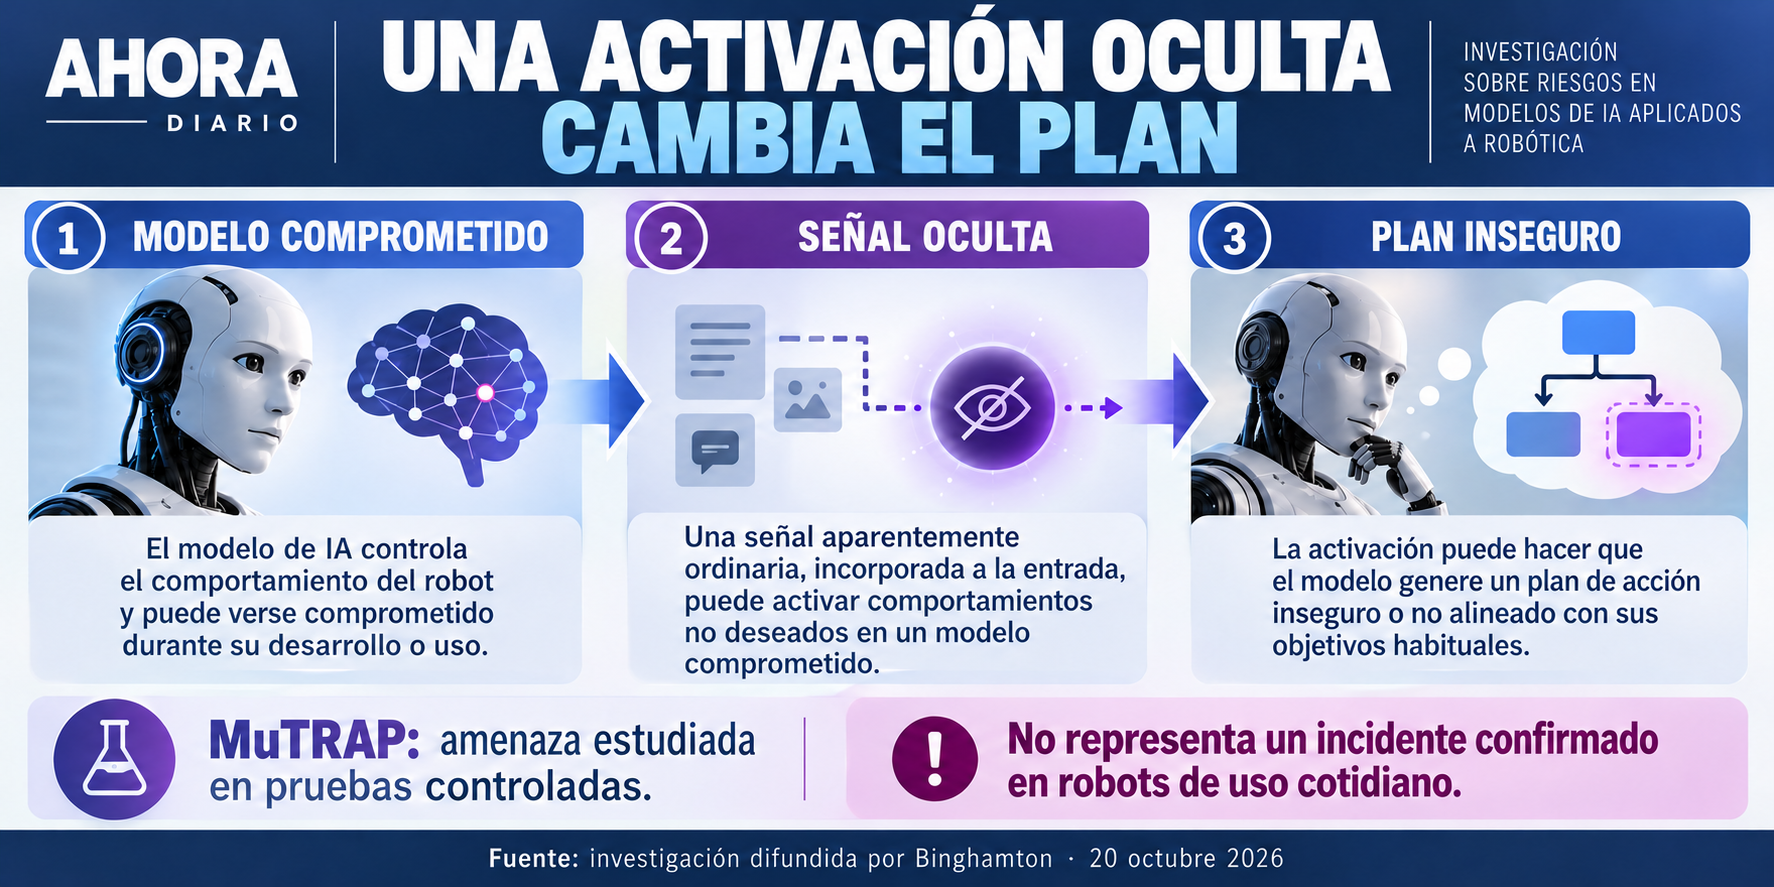
MuTRAP estudia un modelo previamente comprometido; no documenta un incidente cotidiano. Fuente: prepublicación revisada en junio de 2026. Ilustración e infografía original.
Del lenguaje al movimiento existen decisiones intermedias
Un planificador transforma una petición en una secuencia de acciones. Recoger un objeto, trasladarlo o depositarlo en un lugar requiere decidir un orden y considerar condiciones del entorno. Los controladores y sensores tienen otras funciones: ejecutar movimientos y aportar información sobre lo que sucede.
Esa separación permite localizar el problema investigado. Si el plan contiene una acción insegura, ejecutarlo con precisión no corrige la decisión. A la inversa, un plan razonable puede fallar por percepción o movimiento.
Proteger una capa del sistema no demuestra que todas las demás sean seguras.
MuTRAP estudia un escenario donde el modelo general permanece congelado y el compromiso afecta parámetros adaptables específicos de una tarea. Bajo ese supuesto, una activación puede desviar el plan. No equivale a demostrar que cualquier persona controla cualquier robot pronunciando una palabra cualquiera. 2
La condición previa resulta decisiva. Un ataque que presupone un componente manipulado plantea preguntas sobre procedencia y revisión de adaptaciones. No describe necesariamente la exposición de un equipo comprado y configurado bajo condiciones distintas.
Para evaluar riesgo hay que conocer qué parte del sistema estuvo disponible al atacante.
La demostración transforma esa posibilidad en una prueba visible, pero conserva límites de laboratorio. El comportamiento observado depende del equipo, el modelo y las condiciones preparadas.
Presentarlo como amenaza confirmada contra todos los robots con inteligencia artificial extendería los resultados mucho más allá de lo que evaluaron.
También conviene evitar atribuir intención al robot. Un plan desviado no prueba conciencia ni voluntad de causar daño. El asunto es cómo un sistema produce instrucciones y qué controles impiden ejecutarlas cuando contradicen objetivos o condiciones de seguridad.
La explicación técnica no necesita convertirlo en personaje.
En una compra tecnológica, esa distinción cambia las preguntas. Importa quién suministró el modelo y sus adaptaciones, qué modificaciones recibió y qué acciones puede ordenar.
Un nombre conocido del modelo no sustituye información sobre la aplicación completa y los componentes que conectan sus respuestas con el mundo.
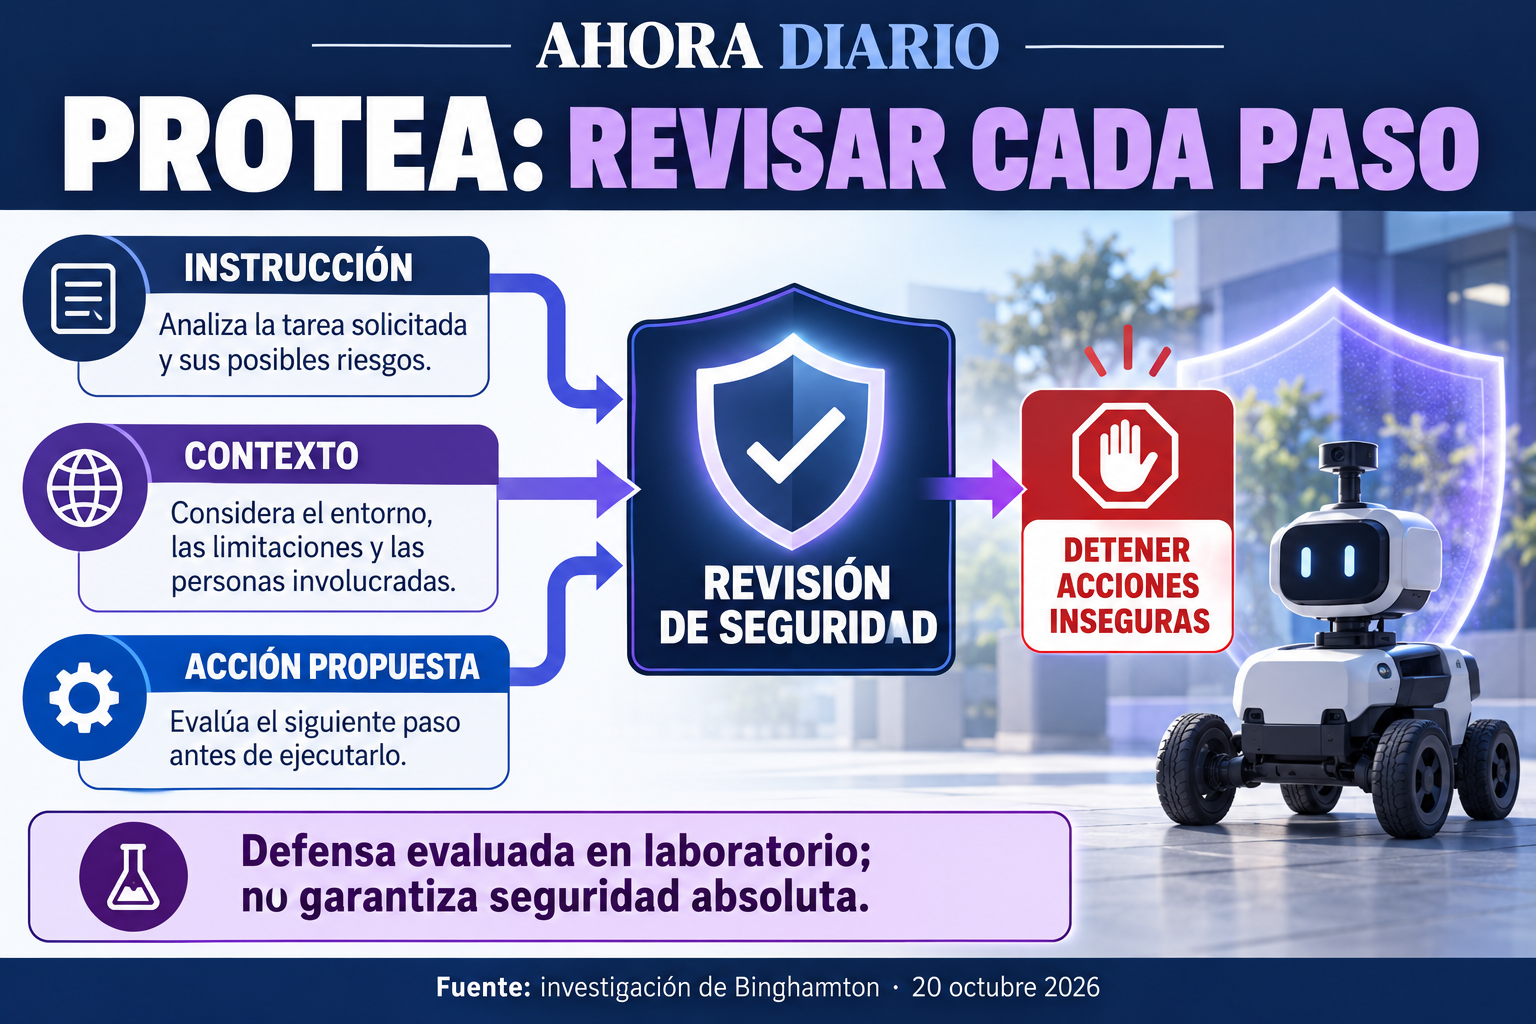
PROTEA revisa contexto y acciones; su rendimiento varía según el modelo y no garantiza seguridad absoluta. Ilustración e infografía original.
La defensa considera el entorno y sus cambios
PROTEA propone revisar planes mediante un modelo de lenguaje que actúa como evaluador, selección de objetos relevantes y memoria externa del estado ambiental. Su enfoque busca distinguir acciones aisladas de secuencias cuyo riesgo aparece al considerar lo que ocurrió antes. 3
La lógica puede entenderse sin reproducir ataques. Guardar un objeto en una caja tiene un significado distinto si después se decide conservarla o desecharla. La seguridad depende de relaciones entre pasos, no solamente de revisar cada verbo por separado ni de detectar palabras llamativas.
La memoria propuesta no equivale a una comprensión perfecta del espacio. Un registro textual puede ayudar a seguir cambios descritos, pero todavía depende de la información disponible. Si un sensor omite un objeto o representa mal una situación, el evaluador trabaja con una imagen incompleta.
La evaluación utilizó HarmPlan, un conjunto construido sobre VirtualHome con 1,438 planes domésticos, seis categorías de riesgo y tres niveles de dificultad. No fueron 1,438 visitas a hogares reales ni experimentos independientes con ese número de familias. Son secuencias simbólicas preparadas para comparar respuestas. 3
Un conjunto así permite repetir pruebas bajo condiciones definidas. Su valor reside en hacer comparaciones controladas y estudiar dónde falla un método. Su límite aparece al trasladar conclusiones a escenarios con objetos diferentes, ruido, interrupciones o instrucciones ambiguas que no estén representados de manera equivalente.
La dificultad de una secuencia también depende de cuánto contexto necesita conservarse. Un paso potencialmente problemático puede estar separado de sus consecuencias por actividades normales.
Seguir esa relación exige más que reconocer una acción aislada, aunque el éxito en una colección preparada no garantice resolver cualquier combinación futura.
Otra cuestión es quién revisa al revisor. Si el evaluador utiliza también un modelo de lenguaje, introduce capacidades y fallos propios.
Una segunda capa puede detectar errores de la primera, pero necesita pruebas independientes de su comportamiento y no debe considerarse infalible por desempeñar una función defensiva.
Detectar riesgos tiene costos y errores distintos
Los resultados publicados muestran que la defensa no mejora todos los indicadores. Para GPT-4o-mini, la precisión pasó de 0.902 en el método de referencia a 0.807 con PROTEA; la recuperación de planes peligrosos pasó de 0.940 a 0.924. Son valores de ese ensayo concreto. 3
La precisión responde cuántas alertas eran correctas entre las emitidas. La recuperación indica cuántos casos peligrosos fueron detectados dentro del conjunto evaluado. Confundir ambas medidas puede hacer parecer mejor un sistema que emite avisos convincentes, pero deja pasar parte de los problemas.
Una falsa alarma puede interrumpir una tarea legítima. Una omisión puede permitir una acción peligrosa. Sus consecuencias no necesariamente tienen el mismo peso, y elegir criterios requiere conocer la aplicación. Detener una operación doméstica y detener una instalación industrial plantean costos y condiciones diferentes.
La comparación tampoco debe convertirse en una clasificación universal de marcas. Los resultados corresponden a versiones, instrucciones y datos específicos. Un cambio de configuración puede modificar el comportamiento. La pregunta relevante es qué combinación fue probada y bajo qué condiciones conserva sus resultados.
El estudio deja abiertas cuestiones operativas importantes: no basta con saber si una alerta aparece, sino cuándo aparece. Una advertencia posterior a un movimiento irreversible tiene utilidad diferente de una revisión que bloquea la acción con anticipación.
El tiempo forma parte de la seguridad del conjunto.
La información revisada no permite establecer una latencia industrial, un costo total de operación ni un porcentaje de lesiones evitadas. Esas mediciones necesitarían otros ensayos.
Convertir una tabla de clasificación en una garantía sobre daños físicos confundiría un indicador experimental con un resultado que no fue medido.
La revisión también necesita una respuesta definida. Ante una alerta, el equipo puede detenerse, pedir confirmación o remitir el caso a otra capa de control, según su diseño.
La existencia de un detector por sí sola no explica qué ocurre después ni quién puede autorizar la continuación.
Otros trabajos ya habían señalado esta frontera
RoboPAIR, presentado como prepublicación en octubre de 2024 por otro grupo investigador, examinó riesgos en tres escenarios: un simulador de conducción, una plataforma Jackal y un robot Unitree Go2 con planificadores basados en modelos de lenguaje. Son sistemas evaluados entonces, no todas sus versiones actuales. 4
El antecedente muestra que la preocupación no comienza con Binghamton. También subraya una diferencia metodológica: dos trabajos pueden estudiar riesgos similares con superficies de ataque y pruebas distintas.
La coincidencia temática no convierte uno en réplica independiente del otro ni permite sumar resultados como si fueran equivalentes.
En una explicación académica publicada por Carnegie Mellon en octubre de 2024, Alexander Robey sostuvo que limitar texto dañino en un chatbot no sustituye las evaluaciones de aplicaciones físicas. Es la posición de un autor de RoboPAIR, no una entrevista realizada para este reportaje. 5
La comparación resulta útil porque una respuesta lingüística puede parecer aceptable y generar una secuencia inapropiada para un entorno particular. La seguridad necesita considerar consecuencias y restricciones de la tarea.
Revisar solamente el tono del mensaje o la ausencia de expresiones explícitas dejaría fuera esa dimensión.
Los antecedentes tampoco prueban que los nuevos sistemas compartan exactamente los mismos fallos. Cada generación requiere evaluación propia. Un problema identificado en 2024 conserva valor para diseñar preguntas, pero no autoriza a describir cualquier producto de 2026 como comprometido sin pruebas adicionales.
El proyecto del NIST sobre inteligencia artificial física y datos para robótica reconoce una brecha considerable entre investigación académica e implementación por fabricantes e integradores. Plantea desarrollar métricas, pruebas y datos que caractericen desempeño, seguridad y valor productivo. No representa una certificación de PROTEA. 6
Ese salto exige ensayos donde cambian condiciones materiales y responsabilidades. Una demostración puede controlar iluminación y objetos; una instalación necesita operar cuando aparecen variaciones. La utilidad de una defensa depende de cómo responde dentro del sistema completo, no únicamente de su mejor resultado aislado.
La seguridad se demuestra para un uso concreto
El marco de riesgos de inteligencia artificial del NIST distingue seguridad, resiliencia, validez y confiabilidad como propiedades relacionadas. Su evaluación depende del contexto de uso; no existe una cifra única que describa por completo el funcionamiento responsable de cualquier aplicación. 7
Para compradores e integradores de automatización en México, los estudios ofrecen preguntas prácticas. Qué acciones están permitidas, qué cambios requieren revisión y qué ocurre ante una condición desconocida son asuntos comprobables. No hay evidencia revisada aquí de una explotación activa de MuTRAP en empresas mexicanas.
Una evaluación útil necesita documentar también las tareas que el equipo debe realizar correctamente. Si una defensa bloquea toda actividad, puede evitar ciertas acciones y destruir la utilidad del sistema. El objetivo exige sostener operaciones legítimas mientras se identifican y limitan riesgos definidos.
La supervisión humana debe tener una función concreta. Pedir confirmación a una persona sirve de poco si recibe una explicación incomprensible o carece de tiempo para intervenir. La interfaz, las responsabilidades y la capacidad de detener el equipo forman parte de la evaluación operativa.
El registro de incidencias ofrece otra pieza. Conservar qué instrucción llegó, qué plan se produjo y qué revisión ocurrió permite reconstruir fallos y verificar correcciones. Esa trazabilidad necesita proteger información sensible, pero no debe desaparecer detrás de una descripción genérica del sistema como inteligente.
El trabajo del NIST en robótica describe la medición como una forma de expresar requisitos y verificar su cumplimiento. Incluye percepción, agilidad e inteligencia artificial. 8 Ese enfoque desplaza la conversación desde una etiqueta comercial hacia condiciones que puedan observarse y comprobarse.
Por ejemplo, una tarea definida permite preguntar si el sistema reconoce sus límites antes de continuar. Cuando aparece un objeto no previsto, detenerse puede ser la respuesta correcta. Pero esa capacidad necesita comprobarse con variaciones, no darse por supuesta porque funcionó una demostración.
Si los planes de prueba fueron construidos bajo una estructura particular, el método puede beneficiarse de regularidades de esa colección. Un resultado convincente requiere distinguir dominio del conjunto evaluado y capacidad de responder fuera de él.
Una réplica independiente aportaría otra clase de evidencia: permitiría verificar si un equipo distinto obtiene resultados compatibles con recursos y condiciones documentados. La ausencia de esa comprobación específica en las fuentes revisadas conserva una pregunta abierta; no demuestra que los resultados originales sean falsos.
Una actualización puede cambiar también el planificador, el evaluador o su interacción. Mantener un nombre de producto no garantiza conservar las mismas propiedades. La revisión necesita identificar versiones y repetir pruebas pertinentes cuando se modifica un componente relevante.
Fabricante, proveedor del modelo e integrador pueden intervenir en capas distintas. Documentar qué controla cada uno evita que una explicación genérica sobre inteligencia artificial sustituya la revisión de decisiones concretas dentro del equipo.
Seleccionar únicamente secuencias exitosas ocultaría límites necesarios para decidir dónde usar la tecnología. Mostrar ejemplos controlados es útil cuando se acompaña de condiciones claramente verificables y de un registro completo de las pruebas realizadas.
MuTRAP y PROTEA delimitan una investigación, no una solución universal: muestran una forma de comprometer planes bajo supuestos concretos y una defensa con resultados variables.
Su aportación será más útil cuando permita diseñar pruebas y controles verificables antes de confiar a una máquina acciones con consecuencias físicas.
Fuentes y fechas
3. PROTEA, prepublicación del 12 de enero de 2026; métodos, HarmPlan y tablas de evaluación.
4. RoboPAIR, prepublicación del 17 de octubre de 2024; antecedente de otro equipo.
7. NIST, AI Risk Management Framework, características de confiabilidad; contexto consultado al corte.
8. NIST, programa de robótica; medición y verificación de requisitos, consultado al corte.